位置编码在transformer中主要是给序列中的向量加上位置的信息,因为attention本身是无法感知位置信息的。两个长度为的序列:,有。我们在计算的score时候会对它们做内积,这个内积和它们的序号是完全没关系的。
参数矩阵位置编码
最简单的做法就是建立一个与序列向量同样大小的可学习参数矩阵作为位置编码,实际上很多有名的工作中都是这么做的,是一个比较简单有效的做法。不过它的坏处在于训练时候的序列长度决定了参数矩阵的大小,实际中推理可能遇到更长的上下文,导致外推性不足(训练与推理文本长度不一致)。
Sinusoidal Position
Embeddings
Attention的论文中利用Sinusoidal Position
Embeddings对序列进行绝对位置的编码。这个思路其实也被广泛应用于diffusion
model中,用于对time
step进行编码。对于向量,其对应的位置编码为:
$$
p_{m, 2i} = \sin\left( \frac{m}{10000^{\frac{2i}{d}}} \right),\\
p_{m, 2i + 1} = \cos\left( \frac{m}{10000^{\frac{2i}{d}}} \right)
$$
其中有的工作中为了简化计算,将维度划分为两段,前半段为,后半段为。最后得到的位置编码也是一个向量,与原向量相加即可。在实际的实现中,由于数值稳定一般会用去计算指数函数,也就是。
Sinusoidal Position
Embeddings得益于三角函数的特性有很多好处,包括数值范围,不同维度对应着不同的频率。可以看到不同序列之间的角度间隔是,只与维度有关系。
Rotary Position Embeddings
(RoPE)
很多时候相对位置的信息也是重要的。相对位置编码要做到,在绝对位置发生变化但是相对位置不变时结果能不变。用数学语言描述一下,假如现在有一个相对位置编码是
,由于attention会做内积,它应该满足:
RoPE现在是大模型最常用的一种相对位置编码策略了,它是通过绝对位置编码去实现相对位置的感知的。对于RoPE的思考过程可以参考苏神的博文https://spaces.ac.cn/archives/8265。这里我们用一个几何的角度去考虑。
首先假设都是二维向量,二维向量的内积只和向量之间的角度与向量的长度相关,即:
而旋转不改变向量长度,且相对旋转一定时,两个旋转后的向量之间的角度也不会变化,因此它们的内积就不会改变。举个例子,两个向量本身的一个角度为。我们根据其在序列中的位置对其进行旋转,角度为,因此旋转后的向量角度就变成了。而它们之间的角度为。这其中前半段由向量本身决定,而后半段即相对旋转角度。因此只要保证就可以进行相对位置编码,非常直接的设计就是。
已知旋转矩阵定义为:
则上述过程写成旋转矩阵就是:
于是相对编码可以设计为对序列中每一个向量都进行等间隔的旋转,而且间隔角度可以直接从Sin编码中拿过来用,所以说RoPE和Sin编码有着千丝万缕的关系。对于向量,我们对它进行编码的方式就是对每一个二维子向量进行旋转,旋转角度为。因此RoPE编码实际上是:
$$ R_{m, i} =
. $$
由于旋转矩阵是做乘法,所以RoPE也是乘性位置编码。为什么Sin编码无法包含相对信息,因为向量相加改变了向量的长度和角度。
对于整个向量来说,这个矩阵是非常稀疏的,做矩阵运算是比较浪费的,可以通过转成向量的点乘去加速计算。而且RoPE位置编码一般放在的linear
layer之后,因为这样它们的旋转信息才不会被破坏。而是被查询的内容,对其进行编码一般来说是无意义的。
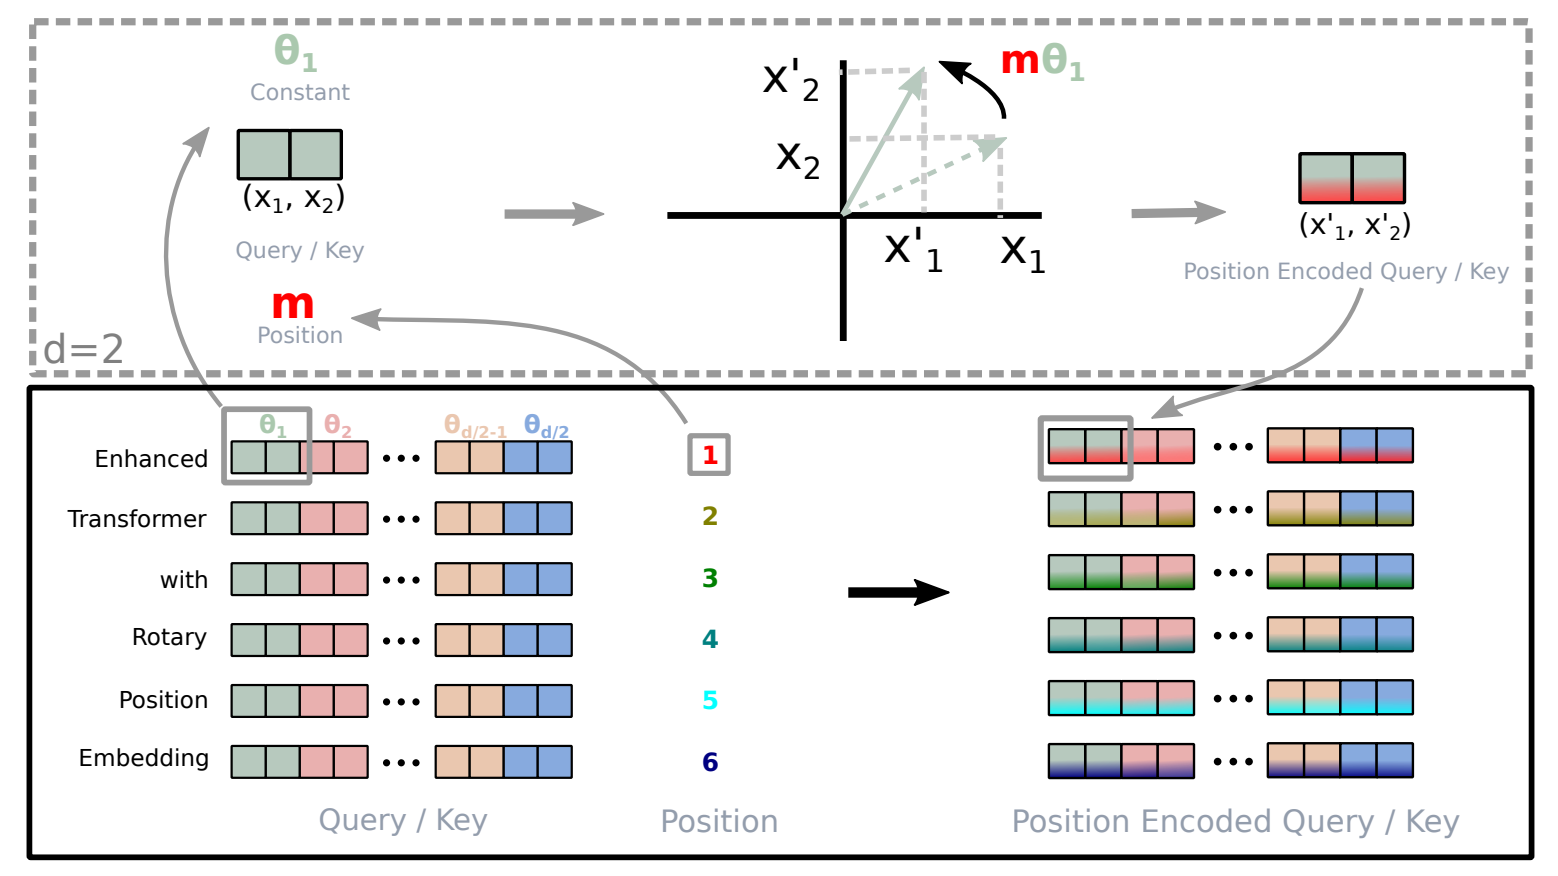 image
最后思考另外一个小问题。如果将向量看成3维子向量呢?三维向量旋转的自由度为3,进行相同次数的等间隔旋转无法保证相对旋转一定。如果限制在一个平面旋转,又会退化为二维的情况了,也就有点多此一举。不过似乎确实有一些三维RoPE的工作,可以有机会再研究。